Como uma chamada de inferência chega a um pod no Kubernetes
Tabela de conteúdos
Preparei uma demo de inferência para a palestra Kubernetes Networking na era da Inteligência Artificial, que apresento com Ricardo Katz no KCD São Paulo 2026. Minha parte acompanha uma requisição: ela entra por um Gateway Istio, encontra um InferencePool e chega a um dos pods que simulam o modelo.
São duas escolhas diferentes. A HTTPRoute define qual pool atende a chamada; o Endpoint Picker (EPP) escolhe um pod daquele pool. Separei as duas de propósito, porque uma resposta lenta e uma requisição sem rota pedem investigações bem diferentes.
Por que inferência muda o roteamento
Em um LLM real, o prefill processa o prompt e monta o KV cache. Depois vem o decode, que gera os tokens de saída um a um. Um prompt longo, uma resposta longa e uma conversa que repete o mesmo prefixo ocupam os servidores de maneiras diferentes. A documentação do llm-d explica essas fases e o papel do cache.
Isso afeta a escolha da réplica. Se um pod já guarda no cache o prefixo do prompt, pode evitar parte do trabalho de prefill. Se está com uma fila grande, pode ser uma escolha ruim para a próxima chamada. O roteamento do llm-d foi pensado para considerar carga e afinidade de cache, sinais que uma simples contagem de requisições não mostra. O EPP também permite filtrar, pontuar e escolher endpoints, conforme os plugins configurados.
Essa é a teoria por trás da arquitetura, não um resultado medido nesta demo. Aqui eu uso llm-d-inference-sim em modo echo. Ele não carrega um LLM real nem usa GPU; o roteiro mostra o roteamento e o pod que respondeu. Não mede ganho de KV cache, nem compara algoritmos de seleção.
A rota escolhe o pool; o EPP escolhe o pod
O cliente roda dentro de um cluster Kind e envia POST /v1/chat/completions, no formato de API compatível com OpenAI. O corpo contém model, mas, nesta demo, esse campo não escolhe a rota. Criei o cabeçalho X-Demo-Pool para isso; ele é uma convenção do exemplo, não um campo obrigatório da Gateway API Inference Extension.
Há uma HTTPRoute para fast e outra para quality. Este é o trecho de fast-route:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: fast-route
  namespace: ai-networking-demo
spec:
  parentRefs:
    - name: fast-inference-gateway
  rules:
    - matches:
        - path: {type: PathPrefix, value: /v1/chat/completions}
          headers:
            - name: x-demo-pool
              value: fast
      backendRefs:
        - group: inference.networking.k8s.io
          kind: InferencePool
          name: fast-router
parentRefs liga a rota ao Gateway. Dentro desse match, o prefixo do caminho e o valor do cabeçalho precisam coincidir. O backendRef aponta para o InferencePool fast-router. O cliente usa POST por causa da API de chat, mas o método HTTP não aparece como condição nesse manifesto. A referência de HTTPRoute detalha como essas condições são combinadas.
O InferencePool agrupa os pods elegíveis por labels, define a porta de destino e aponta para seu EPP. Nos valores do chart para fast, o seletor é app: fast-simulator, na porta 8000; o perfil quality usa app: quality-simulator em seus próprios valores. Cada pool tem seu EPP.
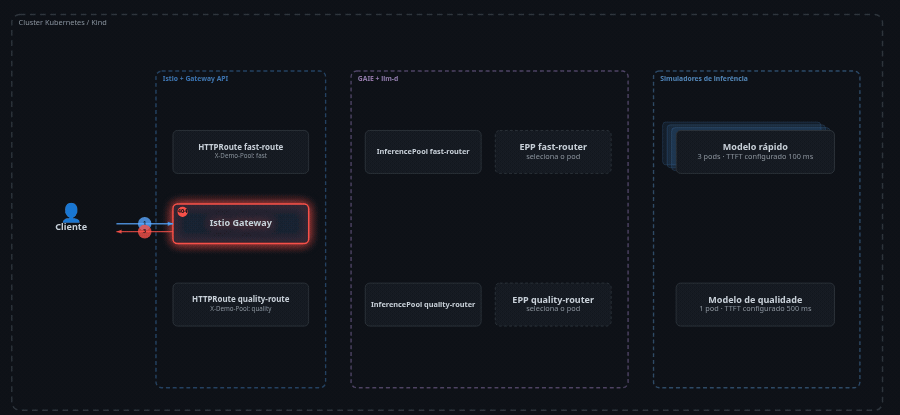
A sequência descrita pela extensão de inferência ajuda a separar decisão de tráfego: o Gateway encontra o pool pela HTTPRoute, consulta o EPP pelo protocolo de processamento externo do Envoy (ext-proc) e, com a resposta, encaminha a requisição HTTP ao pod escolhido. O EPP devolve o endpoint; quem encaminha a chamada e a resposta é o Gateway. O EPP não escolhe o nó do Kubernetes nem troca a chamada para outro pool. Não instalei um Inference Payload Processor (IPP) nesta demo, e a rota não lê o JSON para decidir entre os pools.
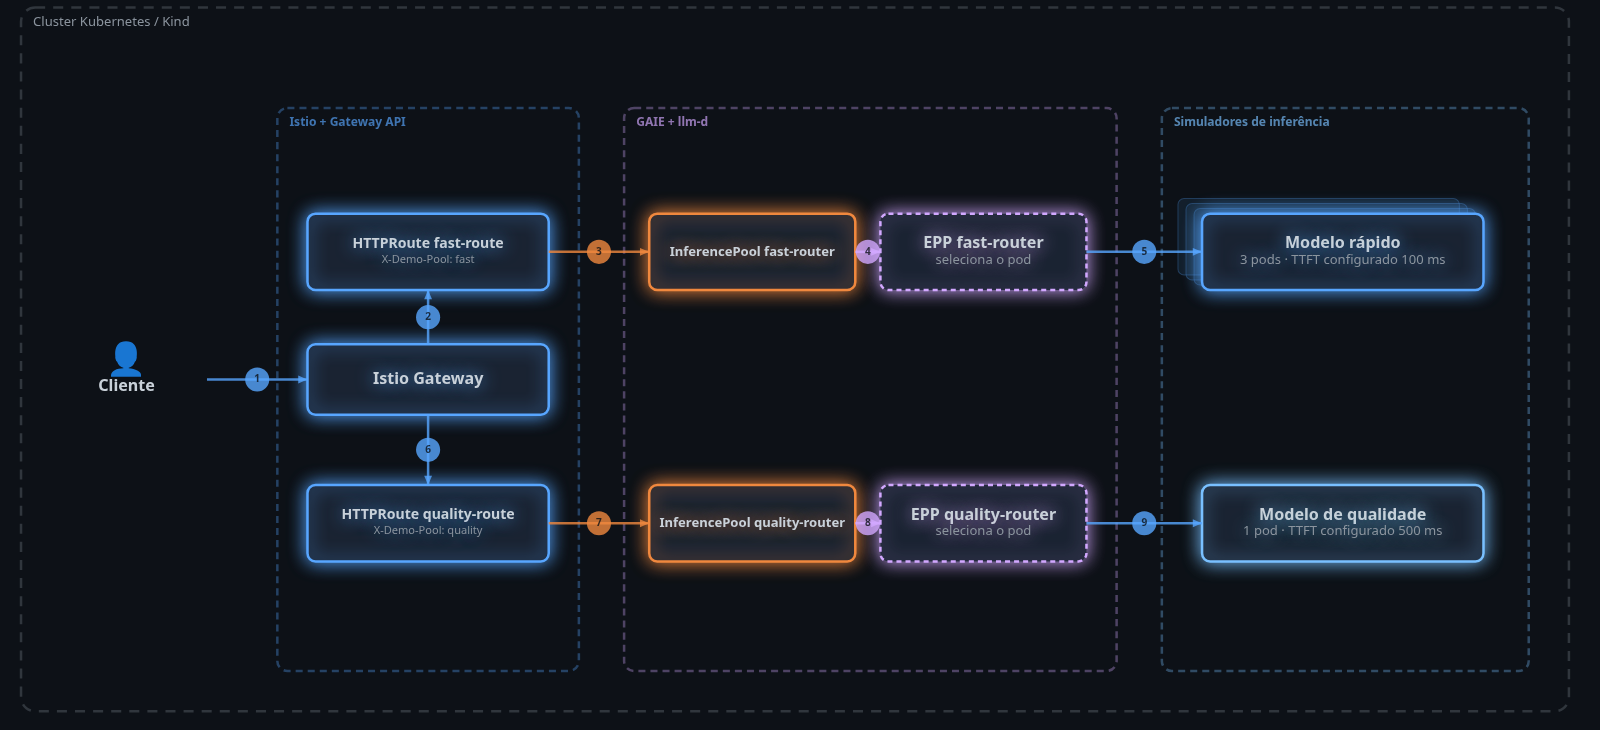 Visão geral das duas rotas e dos dois pools de inferência.
O diagrama interativo geral permite avançar por essas etapas e abrir os recursos de cada uma. As setas representam a sequência das decisões; a requisição HTTP segue do Gateway para o pod escolhido.
O caminho do modelo rápido
Com X-Demo-Pool: fast, a chamada casa com fast-route, usa fast-router e pode chegar a qualquer um dos três pods fast-simulator. O Deployment do simulador configura --mode echo e --time-to-first-token 100ms.
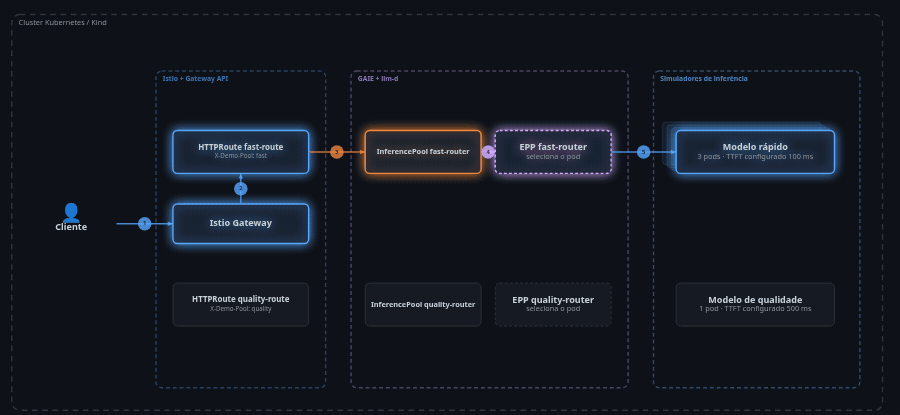 A rota fast e seus três pods candidatos aparecem em destaque.
O fluxo rápido interativo mostra as etapas do diagrama em tamanho maior. A imagem é um quadro do mesmo fluxo, usado na apresentação.
Uma chamada feita pelo cliente dentro do cluster tem esta forma:
kubectl --context kind-kcd-ai-networking-demo -n ai-networking-demo \
  exec deployment/fast-client -- \
  curl -sS -i \
    -H 'Content-Type: application/json' \
    -H 'X-Demo-Pool: fast' \
    -d '{"model":"fast","messages":[{"role":"user","content":"Olá KCD"}]}' \
    http://fast-inference-gateway-istio.ai-networking-demo.svc.cluster.local/v1/chat/completions
Na resposta, olho primeiro para x-inference-pod: ele identifica a réplica que atendeu. O JSON também traz usage, como uma resposta nesse formato de API. Na gravação, envio 12 chamadas concorrentes para fast; elas chegam aos três pods, em uma distribuição de 1, 7 e 4 chamadas. É a contagem daquela execução, não uma promessa de round-robin ou de divisão uniforme.
O caminho do modelo de qualidade
Com X-Demo-Pool: quality, a outra HTTPRoute aponta para quality-router. O EPP desse pool seleciona o único pod quality-simulator, configurado com --time-to-first-token 500ms. O Gateway continua o mesmo; mudam a rota, o pool, o EPP e o pod candidato.
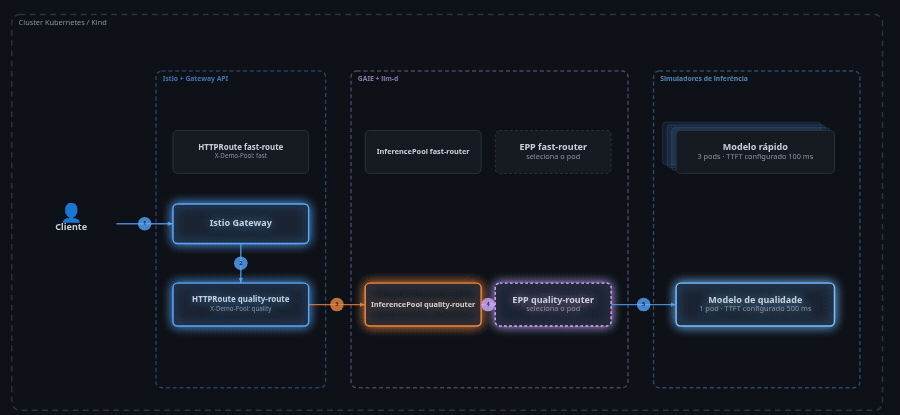 O cabeçalho quality seleciona a outra rota e o único pod daquele pool.
Você pode percorrer o fluxo de qualidade interativo para ver cada recurso. O nome quality serve para diferenciar os perfis do simulador. Como ambos rodam em modo echo, a demo não avalia se uma resposta é melhor que a outra.
O caminho que termina em 404
Envio a mesma API com X-Demo-Pool: invalid. Nenhuma das duas HTTPRoutes aceita esse valor. O Istio Gateway devolve HTTP 404 antes de consultar um InferencePool ou EPP. Por isso a resposta não traz x-inference-pod.
 O valor invalid não encontra rota; o fluxo termina no Gateway.
O diagrama interativo do valor inválido para no mesmo ponto. Chamei o cenário de “pool inválido”, mas o Gateway nem chega a procurar um pool com esse nome. A falha é no casamento da rota. Quando isso acontece, investigar o modelo ou a fila dos pods não explica o 404.
O que o cronômetro realmente mede
Os 100ms e 500ms são atrasos configurados no simulador para o parâmetro chamado time-to-first-token. Na gravação, o roteiro imprime TTFT ao lado de curl -w '%{time_starttransfer}'. O nome da variável é mais preciso que o rótulo do roteiro: segundo a documentação do curl, ela mede desde o início da chamada até o primeiro byte HTTP recebido pelo cliente, incluindo negociação anterior e tempo de servidor. Isso é TTFB (time to first byte).
A requisição da demo não pede stream: true; o cliente não observa separadamente o primeiro token gerado. Por isso não trato o número impresso como TTFT medido de um modelo real. Na gravação, fast ficou em torno de 0,105 s e quality em 0,505 s de TTFB, coerentes com os atrasos configurados, mas incluem também o percurso pelo Gateway e pela rede.
O script de validação confere o prefixo do pod que respondeu e se o primeiro byte de fast chegou antes do de quality. Ele não mede throughput, desempenho de GPU, economia de tokens ou qualidade de resposta. O usage aparece no JSON gravado, mas não faz parte dessa validação. Com um modelo real, medir TTFT exigiria observar a chegada do primeiro token gerado; as etapas seguintes da resposta precisariam de outras métricas.
Assista e rode a demo
A gravação da minha parte pausa em cada etapa para mostrar os pods, as rotas e as respostas. O cluster é preparado antes, com imagens e charts em cache para instalação offline; durante o roteiro, eu inspeciono os recursos e faço as chamadas. O README do projeto traz os pré-requisitos e os comandos para montar o ambiente. Os manifests, scripts e diagramas estão no repositório da demo.